Ce qu’il faut retenir
- Le « kill switch » d’un agent IA n’est pas un bouton rouge unique. C’est un ensemble de mécanismes qui peuvent bloquer une action, retirer un outil, isoler un modèle, mettre un flux en quarantaine ou arrêter l’ensemble du service.
- Arrêter l’IA ne doit pas arrêter le métier : les dossiers entrants, les délais clients, les paiements et les obligations de preuve exigent un mode dégradé préparé, dimensionné et exercé.
- Une action dont le résultat est incertain ne doit jamais être relancée aveuglément. Il faut d’abord la rapprocher de la source de vérité métier, puis décider de confirmer, compenser ou reprendre.
- La reprise est une décision de risque distincte du redémarrage technique. Elle suppose une cause comprise, un périmètre corrigé, des tests de non-régression et une réintroduction progressive.
- Les seuils d’arrêt, les personnes habilitées et les objectifs de reprise dépendent de chaque service d’assurance. Aucun délai ou seuil universel ne peut être déduit d’un cadre général.
Un agent d’intelligence artificielle peut lire un dossier, interroger une base documentaire, appeler une API, créer une tâche et préparer une communication. Cette capacité à enchaîner des opérations produit de la valeur, mais change la nature de l’incident. Une mauvaise réponse isolée peut être corrigée ; une série d’actions exécutées avec les mauvais paramètres peut affecter plusieurs dossiers avant d’être visible.
La réaction intuitive consiste à prévoir un grand bouton d’arrêt. Il est indispensable d’avoir une capacité ultime de coupure, mais elle ne suffit pas. Si l’agent prépare correctement les dossiers tout en envoyant des messages erronés, faut-il arrêter la recherche documentaire, l’extraction et la file de réception ? Si le fournisseur de modèle est indisponible, faut-il empêcher les gestionnaires de consulter les dossiers déjà enrichis ? Si une seule version de prompt est fautive, pourquoi désactiver les autres parcours ?
La bonne conception répond à deux objectifs simultanés : limiter immédiatement les effets indésirables et préserver le service métier essentiel. Elle traite l’arrêt, le repli, la preuve et la reprise comme un même système.
Pourquoi un arrêt global est souvent la mauvaise réponse
Un arrêt global est simple à expliquer et parfois nécessaire : compromission d’un secret, mélange de dossiers, comportement incontrôlé à grande échelle ou impossibilité de déterminer ce qui a été exécuté. Mais utilisé par défaut, il peut aggraver l’incident. Les nouvelles demandes s’accumulent sans priorité, des délais de déclaration ou de réponse approchent, les opérateurs perdent les informations déjà produites et les équipes techniques redémarrent sous pression sans inventaire fiable.
À l’inverse, continuer au motif que des humains valident certaines sorties peut propager le défaut. Une supervision humaine n’intercepte pas nécessairement une anomalie systémique, surtout en période de charge. La stratégie doit donc établir à l’avance quels effets sont tolérables, réversibles ou interdits.
Chaque capacité autonome est décomposée en quatre éléments :
- lecture : quelles données et quels documents l’agent peut consulter ;
- raisonnement : quelles versions de modèle, instructions et bases de connaissance interviennent ;
- action : quels outils peuvent créer, modifier, envoyer, payer ou notifier ;
- orchestration : quelles règles enchaînent, répètent ou délèguent ces actions.
Cette décomposition rejoint la défense contre la prompt injection dans un assistant assurance : réduire les privilèges et valider les arguments rend aussi l’arrêt plus précis. Un outil qui possède trop de droits force l’organisation à choisir entre laisser courir et tout couper.
Une taxonomie des mécanismes d’arrêt
Tableau — Cinq niveaux d’arrêt à combiner selon l’incident
| Niveau | Ce qui est bloqué | Usage typique | Point de vigilance |
|---|---|---|---|
| 1. Garde d’action | Un appel précis ou une classe d’opérations | Interdire l’envoi, le paiement ou la modification tout en conservant la lecture | Les variantes de l’action doivent être couvertes |
| 2. Retrait d’outil | Une API ou un connecteur | Isoler le CRM, la messagerie ou la GED affectée | L’agent ne doit pas contourner par un autre outil |
| 3. Quarantaine de flux | Produit, équipe, type de dossier ou file | Stopper un parcours où le défaut est concentré | Le routage vers la reprise humaine doit fonctionner |
| 4. Isolement de version | Modèle, prompt, base ou configuration | Revenir à une version connue ou passer en lecture seule | La version de repli doit avoir été testée récemment |
| 5. Arrêt du service | Tout le système agentique | Défaut transversal, doute sur l’intégrité ou attaque active | Le métier doit disposer d’un canal de continuité |
Ces niveaux ne sont pas une progression automatique. Une fuite potentielle de données peut exiger l’arrêt global immédiat. Une erreur de formulation limitée à un canal peut être contenue en retirant l’outil d’envoi. La décision dépend de l’impact, de la propagation, de l’observabilité et de la confiance dans le périmètre d’isolation.
Pour chaque niveau, trois choses sont préparées : la commande technique, l’autorité qui peut l’activer et le résultat vérifiable. Un interrupteur qui affiche « désactivé » alors que des tâches déjà mises en file continuent n’a pas rempli sa promesse.
L’architecture qui limite les effets
Permissions courtes et contrôlées
L’agent ne détient pas un accès permanent à tous les outils. Les identités techniques sont séparées par environnement et capacité ; les jetons ont la durée et le périmètre minimaux compatibles avec le service. Les opérations engageantes passent par un service de contrôle qui vérifie le dossier, l’action, les paramètres, le rôle et l’état courant du dispositif.
Le coupe-circuit doit vivre hors du raisonnement du modèle. Demander au même agent de décider s’il doit s’arrêter est insuffisant. Des règles déterministes peuvent refuser une action lorsque le volume, la destination, le montant, le type de donnée, la version ou l’état de santé sortent du domaine autorisé.
Files, états et idempotence
Chaque travail reçoit un identifiant stable et traverse des états explicites : reçu, préparé, validé, engagé, confirmé, en erreur ou à réconcilier. Une commande répétée avec le même identifiant ne doit pas créer un second effet lorsque l’opération métier peut être rendue idempotente. Lorsque ce n’est pas possible, le système bloque la répétition et exige une vérification.
La file d’attente est compartimentée. Mettre en pause les envois n’empêche pas de recevoir des pièces ; arrêter un modèle ne détruit pas les demandes ; isoler un produit ne bloque pas tous les autres. Les données nécessaires à la reprise sont conservées selon une politique définie, avec des contrôles d’accès et une durée proportionnée.
Traces assez riches pour répondre à trois questions
- Qu’est-ce que le système avait l’intention de faire ?
- Qu’est-ce qui a été demandé aux outils ?
- Quel effet est confirmé dans la source de vérité métier ?
Une trace du texte généré ne suffit pas. Il faut la version de configuration, l’identité, le périmètre, l’horodatage, l’identifiant métier, le résultat technique et le lien vers la confirmation métier. Le guide sur l’observabilité des systèmes génératifs détaille la séparation entre preuve utile et duplication incontrôlée des dossiers.
Un plan de contrôle indépendant du chemin nominal
Le mécanisme d’arrêt ne doit pas dépendre uniquement de l’interface, du modèle ou du fournisseur qu’il doit isoler. Conservez un chemin d’administration séparé, protégé par une authentification forte, dont l’état peut être vérifié depuis l’extérieur du flux nominal. Une révocation d’urgence des identités techniques complète les interrupteurs applicatifs lorsque leur fonctionnement n’est plus digne de confiance.
Testez également le comportement après coupure : les travailleurs déjà lancés relisent-ils l’état d’autorisation avant chaque action ? Les tâches mises en file expirent-elles ou repartent-elles au redémarrage ? Un cache peut-il maintenir un droit retiré ? Les appels en lecture restent-ils possibles lorsque l’écriture est bloquée ? Ces questions transforment un drapeau de configuration en barrière réelle.
Le principe de prudence est déterministe : lorsqu’un composant ne peut pas confirmer l’autorisation d’une action engageante, il refuse ou oriente vers la reprise prévue. Ce comportement doit être testé sous perte de réseau et indisponibilité partielle, car un coupe-circuit accessible uniquement quand tout fonctionne ne protège pas l’incident auquel il est destiné. La confirmation de chaque barrière est journalisée.
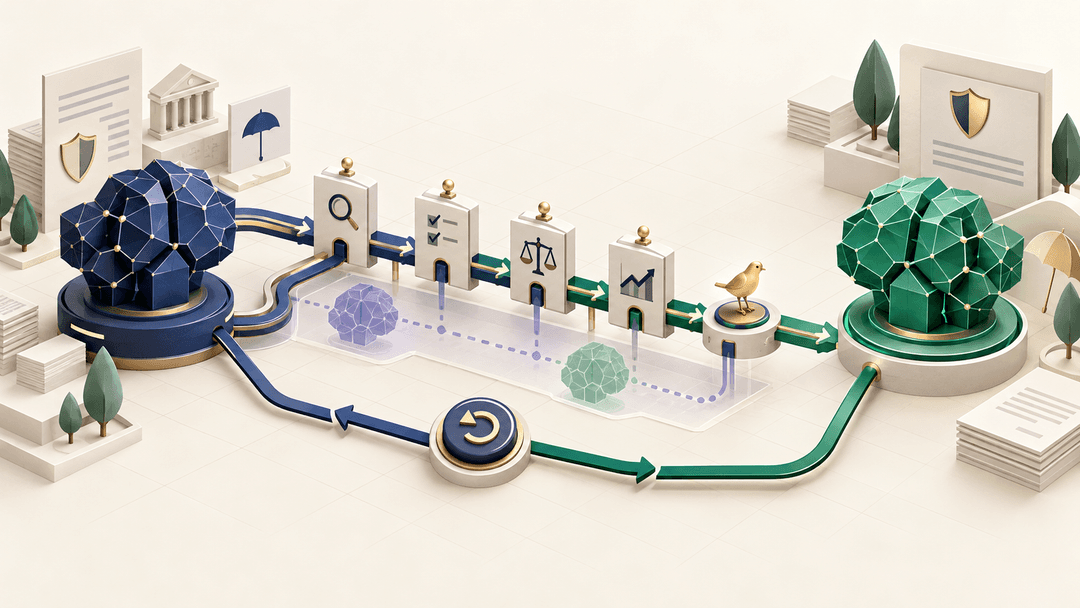
La séquence d’incident, de l’alerte à la reprise
- Détecter : recevoir l’alerte, la réclamation, le signal technique ou l’observation humaine ; préserver son contexte.
- Qualifier rapidement : identifier l’effet potentiel, la propagation, les données concernées et la capacité à délimiter le défaut.
- Contenir : choisir le périmètre d’arrêt le plus sûr, révoquer les capacités nécessaires et vérifier que la coupure est réelle.
- Basculer : activer la file et les procédures du mode dégradé, informer les équipes et protéger les priorités métier.
- Préserver : figer les versions, identifiants, traces et états nécessaires à l’analyse, sans multiplier les copies de données sensibles.
- Réconcilier : rapprocher les actions en vol de la GED, du CRM, du système de gestion, du paiement ou de la messagerie.
- Corriger : traiter la cause, les dossiers affectés et les conséquences clients ; ajouter des tests de non-régression.
- Décider la reprise : faire valider le risque résiduel par l’autorité prévue et réouvrir progressivement.
- Apprendre : revoir le scénario, les seuils, la détection, le repli et la documentation.
Le NIST SP 800-61 révision 3, publié en avril 2025, inscrit la réponse à incident dans la gestion continue du risque et articule préparation, détection, réponse, récupération et amélioration. Ce cadre est volontaire et généraliste ; il aide à structurer la discipline, sans définir à la place d’un assureur les priorités d’un flux de sinistres ou de souscription.
Pour les entités financières dans son champ, le règlement DORA demande notamment une politique de continuité des activités TIC et des dispositifs documentés pour répondre, contenir, reprendre et récupérer. Ses articles 11 et 12 traitent de continuité, réponse, sauvegarde, restauration et tests. DORA ne prescrit pas un bouton propre aux agents IA : il fournit un cadre auquel le service concerné doit être relié selon sa criticité.
Réconcilier les actions en vol et incertaines
Le cas le plus dangereux n’est pas toujours l’échec explicite. C’est la réponse absente après une demande : l’agent ignore si l’outil a exécuté l’action avant la coupure réseau. Relancer peut alors dupliquer un message, une tâche, un mouvement ou une modification.
La procédure de réconciliation part de la source de vérité métier, jamais du seul journal de l’agent :
- geler les nouvelles actions du même type ;
- extraire la liste des demandes dont l’état n’est pas confirmé ;
- interroger le système cible avec l’identifiant stable, sans mutation ;
- classer chaque élément : non exécuté, exécuté conforme, exécuté non conforme, doublon ou encore indéterminé ;
- faire valider la correction ou la compensation selon le coût d’erreur ;
- ne reprendre l’automatisation qu’après rapprochement du stock et correction de la cause.
Les opérations ne sont pas toutes compensables. Un brouillon peut être supprimé, une tâche réaffectée, mais un courriel déjà reçu ou une décision communiquée ne disparaît pas. L’organisation doit prévoir la rectification, l’information et, si nécessaire, le traitement d’une réclamation. Appeler toute action « réversible » parce qu’une API propose un DELETE crée une illusion technique.
Construire le mode dégradé métier
Le mode dégradé n’est pas « tout faire à la main comme avant ». Les volumes, les équipes et les interfaces ont pu changer. Il faut définir le service minimum et accepter explicitement ce qui sera différé. Pour un flux donné, la fiche de repli précise :
- le canal qui continue de recevoir les demandes ;
- les données minimales accessibles sans l’agent ;
- la règle de priorité : urgence client, délai contractuel, vulnérabilité, montant ou autre critère validé ;
- les opérations autorisées et celles suspendues ;
- les effectifs mobilisables, leurs habilitations et leurs plages de disponibilité ;
- le message interne et, si nécessaire, le message client ;
- la limite de capacité et le déclencheur d’un renfort ;
- la manière de réinjecter ensuite les dossiers sans doublon.
Le dimensionnement doit se faire sur le flux réel et ses pointes. L’analyse de la capacité d’un service IA pendant les pics de sinistres aide à distinguer latence technique, délai métier et file d’attente. La même discipline s’applique au repli : l’objectif n’est pas de conserver chaque fonctionnalité, mais de protéger les décisions et services essentiels.
Scénario hypothétique : un agent pendant un pic de sinistres
Imaginons un agent qui classe les déclarations, extrait les informations de pièces jointes, propose une priorité et prépare un accusé de réception. Après une mise à jour, des dossiers comportant certaines pièces sont parfois associés au mauvais motif. Ce scénario est pédagogique ; il ne décrit aucun incident réel.
L’équipe ne sait pas encore si l’erreur touche l’extraction, le modèle ou le routage. Elle met en quarantaine la classe de dossiers concernée, retire la capacité d’envoi pour cette file et maintient la réception. Les accusés des autres produits continuent si leur chaîne est indépendante et contrôlée. Les dossiers quarantainés reçoivent un état visible et sont orientés vers une file humaine priorisée.
Les actions en vol sont rapprochées avec la messagerie : envoyé, brouillon, absent ou indéterminé. Aucun message indéterminé n’est relancé avant vérification. L’équipe compare les versions, reproduit le défaut sur des données de test et ajoute un contrôle déterministe de cohérence. La reprise commence sur une petite part des dossiers, sans envoi automatique, puis élargit le périmètre après observation.
Le succès de la réponse ne serait pas « service redémarré ». Il serait documenté par la limitation des dossiers affectés, la continuité de réception, la réconciliation complète, le traitement des clients concernés et la preuve que le défaut ne se reproduit plus dans le domaine testé.
Un exercice de reprise exploitable
Avant l’exercice
Choisissez un flux réel mais un environnement sans effet client. Fixez le scénario, les observateurs, les canaux, les sources de vérité et les critères. Les personnes opérationnelles ne doivent pas toutes connaître à l’avance l’emplacement exact du défaut. Préparez un moyen sûr d’injecter l’événement et de restaurer l’environnement.
Pendant l’exercice
- déclencher une anomalie observable et mesurer le temps jusqu’à sa qualification ;
- demander au décideur de choisir un périmètre d’arrêt et d’expliquer le compromis ;
- vérifier que les capacités sont réellement révoquées, y compris pour les tâches en file ;
- faire traiter un lot prioritaire en mode dégradé ;
- introduire quelques actions au statut incertain et observer la réconciliation ;
- demander une décision argumentée de reprise, puis une réouverture progressive ;
- collecter les ambiguïtés de rôle, accès manquants et contournements.
Après l’exercice
Mesurez séparément détection, décision, activation, confirmation de l’arrêt, continuité du service, réconciliation, correction et reprise. Les objectifs sont internes au service. Ils dérivent de l’analyse d’impact et de la capacité opérationnelle, pas d’un chiffre emprunté à un autre assureur. Chaque défaut observé devient une action nommée, datée et retestée.
Le Playbook du NIST AI RMF, fonction Measure, recommande notamment de tester sous stress, de documenter la capacité à échouer de manière sûre et d’exercer les plans de réponse. Le Playbook est volontaire et en cours d’évolution ; il soutient la méthode de test, non une présomption de conformité.
Gouvernance, preuves et limites
La matrice d’autorité doit distinguer l’activation et la reprise. Les opérations peuvent suspendre immédiatement un envoi ; la sécurité peut révoquer un secret ; le produit peut désactiver une version ; le responsable métier et le risque peuvent autoriser la reprise selon le périmètre. Un comité trop lourd rend l’arrêt inutilisable, mais une seule personne sans suppléant crée une dépendance dangereuse.
Pour les systèmes d’IA à haut risque concernés, l’article 14 du règlement (UE) 2024/1689 inclut parmi les capacités de contrôle humain la possibilité d’intervenir ou d’interrompre le système en sécurité. Cela renforce l’importance de l’arrêt conçu ; cela ne permet pas de conclure que tout agent d’assurance relève de ce régime.
Depuis l’entrée en vigueur, le 27 juillet 2026, du règlement (UE) 2026/1744, ces exigences de l’article 14 s’appliquent à compter du 2 décembre 2027 aux systèmes à haut risque relevant de l’article 6, paragraphe 2, et de l’annexe III, et du 2 août 2028 à ceux relevant de l’article 6, paragraphe 1, et de l’annexe I.
L’avis de l’EIOPA sur la gouvernance IA relie une utilisation responsable à des responsabilités claires, une documentation ordonnée, une gestion des données et une approche proportionnée au risque. Pour une équipe, la conséquence concrète est de rattacher le mécanisme d’arrêt au propriétaire du processus, au registre du système, au dispositif de continuité et aux incidents, plutôt que de le laisser dans une documentation purement technique.
Enfin, aucun exercice ne couvre tous les modes de défaillance. Un mécanisme d’arrêt peut lui-même être indisponible, mal habilité ou dépendre du composant qu’il doit couper. Testez-le depuis un chemin d’administration séparé, surveillez son état et prévoyez une révocation de dernier recours. La résilience vient de plusieurs barrières cohérentes, pas d’un artefact unique.
Questions fréquentes
Faut-il laisser un bouton d’arrêt à chaque utilisateur ?
Chaque utilisateur doit pouvoir suspendre ou signaler le traitement de son dossier. Les arrêts plus larges suivent des habilitations et une astreinte explicites. Le dispositif doit privilégier une alerte sûre et rapide plutôt qu’un accès universel à la coupure globale.
Peut-on simplement revenir au modèle précédent ?
Seulement si la cause se situe bien dans la version du modèle et si la version précédente, ses dépendances et ses tests restent disponibles. Un défaut de données, de droits ou d’orchestration survivrait au retour arrière.
Quand faut-il reprendre ?
Lorsque le périmètre affecté est compris, les actions en vol sont maîtrisées, la correction a été testée, le mode de reprise est observable et l’autorité compétente accepte le risque résiduel. Le rétablissement d’un indicateur technique n’est qu’un élément.
Le kill switch couvre-t-il aussi un fournisseur externe ?
Il doit pouvoir isoler le fournisseur, révoquer ses accès et orienter le flux vers une solution de repli. Le contrat, l’architecture et l’exercice de réversibilité déterminent si cette capacité est réelle.
Sources et références
- Règlement (UE) 2022/2554 sur la résilience opérationnelle numérique du secteur financier (DORA), notamment articles 11, 12 et 28 ; texte officiel consulté le 7 septembre 2026.
- NIST SP 800-61 révision 3, Incident Response Recommendations and Considerations for Cybersecurity Risk Management, avril 2025.
- NIST AI RMF Playbook — Measure, ressource opérationnelle volontaire consultée le 7 septembre 2026.
- EIOPA, Opinion on Artificial Intelligence governance and risk management, 6 août 2025.
- Règlement (UE) 2024/1689 sur l’intelligence artificielle, notamment article 14 ; texte officiel consulté le 7 septembre 2026.
- Règlement (UE) 2026/1744 modifiant le calendrier d’application du règlement IA, entré en vigueur le 27 juillet 2026.
Tester l’arrêt avant le premier incident
Un exercice court révèle souvent les dépendances que l’architecture et le contrat ne montrent pas : tâches en vol, droits manquants, file humaine saturée ou reprise sans preuve. Préparons un scénario d’arrêt et de continuité adapté à votre processus d’assurance.