Ce qu’il faut retenir
- Une anomalie documentaire n’est pas une fraude. L’IA peut signaler une incohérence, une altération probable ou une combinaison atypique. Elle ne connaît pas à elle seule l’intention, le contexte ni l’explication légitime.
- La chaîne doit séparer six fonctions. Acquisition, extraction, contrôle de cohérence, détection d’anomalie, priorité d’examen et enquête ne produisent pas la même information et ne justifient pas les mêmes actions.
- Le système doit savoir s’abstenir. Un document illisible, une donnée absente ou un modèle hors domaine doivent conduire à une demande de pièce ou à une revue, pas à un soupçon plus fort.
- La mesure pertinente dépend du risque. Il faut suivre les faux positifs et faux négatifs, mais aussi les délais, les renversements humains, la concentration par population, la qualité des preuves et l’effet réel sur les personnes.
- L’humain doit pouvoir contredire le signal. Il lui faut du temps, le document source, la raison de l’alerte, des alternatives possibles et l’autorité de classer sans suite.
Utiliser l’IA pour repérer des anomalies documentaires en assurance est raisonnable si sa sortie reste ce qu’elle est : un signal à examiner. La conception devient dangereuse lorsque le score déclenche directement un refus, un blocage durable, une inscription sur une liste ou une accusation. Entre l’image reçue et la qualification de fraude, plusieurs étapes de preuve, de contexte et de décision doivent rester distinctes.
La méthode proposée ici organise cette séparation. Elle s’applique aux dossiers de souscription, déclarations de sinistre, justificatifs, factures, devis, attestations et pièces d’identité, avec des adaptations selon le produit et la finalité. Elle ne remplace ni l’analyse juridique du traitement, ni les procédures antifraude de l’organisme. Elle fournit une architecture de décision qui réduit le risque de transformer l’incertitude technique en jugement sur une personne.
Le point de départ : un signal décrit un document, pas une intention
Un numéro de facture au format inhabituel peut provenir d’un faux, d’un nouveau logiciel comptable ou d’une saisie manuelle. Deux photos visuellement proches peuvent signaler un réemploi, mais aussi un doublon envoyé par erreur. Une date incohérente peut révéler une altération ou simplement un document établi dans un autre fuseau, un formulaire prérempli ou une mauvaise extraction OCR.
Le vocabulaire du système doit préserver cette incertitude. « Écart entre le montant extrait et le total recalculé » décrit un fait vérifiable. « Facture frauduleuse » affirme une qualification que le modèle ne peut généralement pas établir seul. Entre les deux, on peut exprimer une hypothèse : « incohérence nécessitant une vérification de la pièce et du contexte ».
Fait sourcé. La CNIL, dans sa fiche consacrée au secteur de l’assurance, distingue elle-même la détection d’une anomalie, d’une incohérence ou d’un signalement susceptible de relever d’une fraude de la suite donnée au dossier, laquelle peut notamment nécessiter des éléments complémentaires. Cette formulation invite à conserver plusieurs niveaux de qualification.
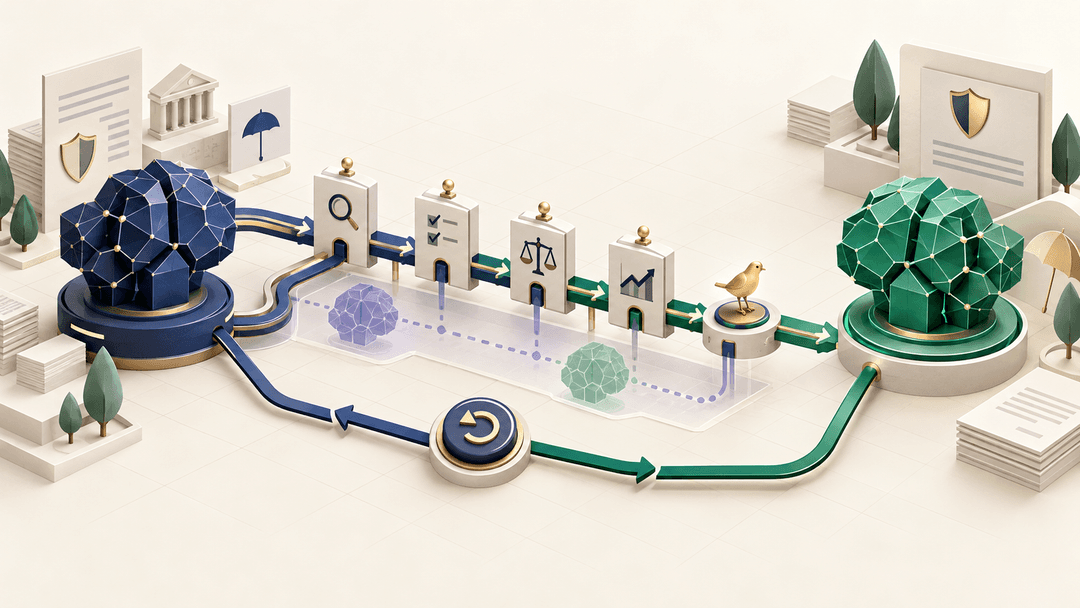
La chaîne en six étapes
- Acquisition. Recevoir le document, contrôler son type, son intégrité technique, son canal et les métadonnées qu’il est légitime de traiter.
- Extraction. Lire des champs, des zones et des relations, avec une provenance précise vers la page ou la région source.
- Contrôle de cohérence. Comparer les valeurs entre elles, avec les règles du document et avec les autres pièces du dossier.
- Détection d’anomalie. Repérer un écart par rapport à une règle, une distribution ou un motif appris, en conservant la raison du signal.
- Priorité d’examen. Ordonner le travail humain selon la gravité possible, l’incertitude et la capacité à obtenir une preuve complémentaire.
- Enquête et qualification. Vérifier les sources, contacter si nécessaire, confronter les explications et appliquer la procédure métier avec les personnes habilitées.
Cette décomposition évite qu’un même nombre — le « score de fraude » — mélange qualité de lecture, rareté statistique et suspicion. Un faible score OCR ne rend pas le document plus frauduleux ; il rend la conclusion moins fiable. Une architecture saine peut donc augmenter la priorité de revue tout en abaissant le niveau de certitude sur l’hypothèse.
L’article sur le Document AI en assurance détaille déjà la différence entre OCR, mise en page, extraction et contrôle humain. Pour l’antifraude, cette séparation est encore plus importante : une erreur d’extraction ne doit pas devenir un indice contre la personne.
Une taxonomie des signaux qui ne confond pas les causes
Avant de choisir un modèle, il faut nommer les familles de signaux et la preuve que chacune peut produire.
| Famille | Exemple de signal | Ce que le signal établit | Prochaine vérification |
|---|---|---|---|
| Qualité d’entrée | Zone illisible, page manquante, compression forte | La lecture est incertaine | Obtenir une meilleure copie ou saisir manuellement |
| Structure | Champ attendu absent, ordre de pages atypique | Le document diffère du modèle connu | Identifier la version ou le type réel du document |
| Cohérence interne | Total différent de la somme des lignes | Les valeurs présentes ne concordent pas | Vérifier lecture, taxes, remises et arrondis |
| Cohérence croisée | Date ou identité différente entre deux pièces | Le dossier contient des informations incompatibles | Vérifier les versions et demander une explication |
| Trace numérique | Métadonnée ou couche graphique inhabituelle | Le fichier a une caractéristique technique atypique | Contrôler l’origine et la chaîne de transmission |
| Similarité | Image proche d’une pièce déjà reçue | Deux contenus partagent des motifs | Comparer les originaux et les contextes d’usage |
| Rareté statistique | Combinaison peu fréquente de montants et de postes | Le cas est éloigné de la population de référence | Contrôler la représentativité et le contexte métier |
| Règle métier | Pièce incompatible avec le produit ou la date | Une règle explicite semble non satisfaite | Vérifier la règle applicable et les exceptions |
Cette taxonomie permet d’adapter le libellé, la priorité et la preuve attendue. Elle évite aussi une erreur classique : traiter la rareté comme une faute. Des personnes, entreprises ou parcours peu représentés dans l’historique produiront mécaniquement davantage de signaux d’écart si le modèle apprend surtout la norme majoritaire.
Séparer incertitude technique et risque métier
Deux axes suffisent souvent à rendre la décision plus honnête :
- Confiance dans l’observation : le champ a-t-il été lu correctement, la pièce est-elle complète, la comparaison est-elle fiable ?
- Impact potentiel : si l’incohérence est réelle, quelle conséquence peut-elle avoir sur le traitement, les droits ou le montant ?
Une observation peu fiable et potentiellement grave appelle une nouvelle pièce ou une revue experte, pas une accusation plus ferme. Une observation très fiable mais de faible impact peut être corrigée dans le flux ordinaire. Cette matrice est plus utile qu’un score unique, car elle guide une action proportionnée.
Recommandation. Conserver séparément la valeur extraite, l’indicateur de qualité, la règle déclenchée, la priorité et la décision humaine. Si l’on ne peut plus distinguer ces couches dans les journaux, il devient impossible de comprendre si une personne a été affectée par un document, une erreur de lecture, un seuil ou une décision de l’enquêteur.
Concevoir l’abstention
Un bon système ne répond pas toujours. Il peut déclarer : « type de document inconnu », « qualité insuffisante », « conflit non résolu entre deux sources », « référence absente du corpus » ou « règle métier non applicable avec certitude ». Ces sorties doivent être prévues dans le contrat et reliées à une action sûre.
L’abstention n’est pas uniforme. Elle peut déclencher :
- une seconde extraction par une méthode différente ;
- une demande ciblée de page ou de justificatif ;
- une vérification par un gestionnaire sans marqueur antifraude ;
- une orientation vers un enquêteur lorsque plusieurs éléments indépendants le justifient ;
- l’arrêt du traitement automatisé si l’entrée est hors périmètre.
Il faut mesurer l’abstention par segment. Un taux global acceptable peut cacher une incapacité systématique sur un modèle de document utilisé par un réseau, une région ou un type d’assuré. Dans ce cas, la bonne réponse peut être d’améliorer l’acquisition ou de créer une voie dédiée, non d’abaisser le seuil de confiance.
La matrice d’escalade
La matrice suivante illustre une organisation possible. Les seuils exacts doivent être décidés selon le processus, la réglementation applicable et les coûts d’erreur.
| Niveau | Situation | Action permise | Action interdite sans examen supplémentaire |
|---|---|---|---|
| 0 — Qualité | Document illisible ou format inconnu | Redemander la pièce, améliorer la capture, saisir manuellement | Créer un soupçon de fraude |
| 1 — Écart simple | Incohérence explicable par saisie, version ou arrondi | Contrôle de cohérence et demande de précision | Bloquer durablement ou qualifier une intention |
| 2 — Signaux convergents | Plusieurs anomalies indépendantes, document lisible | Prioriser une revue habilitée et préserver les éléments | Décider automatiquement d’une conséquence significative |
| 3 — Élément vérifié | Une source indépendante confirme une altération ou une incohérence matérielle | Appliquer la procédure d’enquête et les contrôles contradictoires prévus | Étendre la qualification à d’autres dossiers sans preuve |
| 4 — Décision | Analyse menée par l’autorité compétente selon la procédure | Décision motivée, traçable, contestable selon le cadre applicable | Présenter le score IA comme la justification unique |
Le niveau ne doit pas monter parce que le dossier reste longtemps en file. L’ancienneté peut augmenter la priorité de traitement, pas la force de la preuve. De même, la présence de plusieurs signaux provenant de la même erreur d’extraction ne constitue pas une convergence indépendante.
Un contrôle humain qui peut réellement changer le résultat
Afficher un bouton « valider » ne garantit pas une intervention humaine. Le gestionnaire peut être influencé par un score opaque, manquer de temps ou ne pas accéder au document source. Il peut aussi craindre qu’un désaccord dégrade ses indicateurs. Le contrôle devient alors symbolique.
Pour être effectif, le réviseur doit voir :
- le document original et la zone à l’origine du signal ;
- la valeur extraite et, séparément, le niveau de qualité de lecture ;
- la règle ou comparaison déclenchée, formulée sans accusation ;
- les autres explications plausibles et les données manquantes ;
- la conduite attendue pour obtenir un élément complémentaire ;
- l’historique des décisions et la possibilité de corriger le système.
Il doit aussi avoir l’autorité de classer sans suite, de demander une nouvelle pièce ou d’escalader, avec une justification proportionnée. L’article sur le contrôle humain effectif en assurance détaille cette différence entre un clic et une supervision réelle.
Fait sourcé. La CNIL rappelle que l’article 22 du RGPD encadre les décisions fondées exclusivement sur un traitement automatisé lorsqu’elles produisent des effets juridiques ou affectent significativement une personne. L’applicabilité exacte dépend du dispositif. La conception doit donc examiner non seulement le schéma officiel, mais la réalité : un signal placé au fond d’une file trop longue pour être revu peut avoir un effet pratique même si une validation humaine existe en théorie.
Données personnelles : finalité et minimisation
La détection documentaire peut inciter à conserver davantage : originaux, métadonnées, images, historiques et rapprochements entre dossiers. Cette accumulation n’est pas neutre. Le traitement doit avoir une finalité définie, une base légale qualifiée, des destinataires, une durée et des mesures de sécurité adaptées. Les informations sensibles ne doivent pas être collectées parce qu’elles pourraient un jour améliorer un modèle.
Dans l’assurance, la CNIL insiste sur le principe de minimisation et sur la vigilance particulière applicable au NIR et aux données de santé. Une chaîne antifraude doit donc préciser quelles zones sont nécessaires à chaque contrôle. Masquer un champ non utile avant l’analyse est souvent préférable à promettre qu’il ne sera pas utilisé après collecte.
Les données de résultat méritent la même attention. Un indicateur « anomalie détectée », un score ou une inscription dans une liste peut devenir une donnée dérivée lourde de conséquences. Il faut en organiser l’exactitude, la rectification, la durée, l’accès et la suppression selon le cadre retenu. Une correction du dossier source doit pouvoir se propager aux signaux qui en dépendaient.
Mesurer la qualité par risque
La précision et le rappel restent utiles, mais ils ne suffisent pas. Leur interprétation dépend du niveau de la chaîne. Un faux positif d’extraction est une valeur mal lue ; un faux positif d’alerte envoie inutilement un dossier en revue ; un faux positif de décision peut affecter directement une personne. Les coûts ne sont pas comparables.
Le tableau de bord devrait couvrir au moins :
- Qualité de lecture : exactitude par champ, taux de documents hors domaine, calibration des indicateurs de confiance.
- Qualité des signaux : part d’alertes confirmées comme incohérence matérielle, doublons de signaux, raisons les plus fréquentes.
- Charge humaine : temps de revue, file d’attente, dossiers non examinés, demandes de pièces évitables.
- Renversements : décisions humaines contraires au signal, motifs de classement sans suite, corrections après contestation.
- Segmentation : écarts par produit, canal, format documentaire et autres groupes pertinents et licitement mesurables.
- Impact : retards, blocages, escalades et conséquences significatives associés au dispositif.
- Preuve : proportion d’alertes reliées à une zone source, une règle explicite et une version de modèle identifiable.
Recommandation. Fixer séparément un budget de faux négatifs et un budget de faux positifs selon le niveau. Chercher à capturer tous les cas au premier filtre peut saturer les enquêteurs ; une file saturée transforme un système sensible en tri automatique de fait. Inversement, optimiser la précision en ne signalant que les cas évidents peut manquer la finalité. La capacité réelle de revue fait partie du modèle de risque.
Trois scénarios fictifs pour tester la chaîne
Scénario 1 — La facture recalculée
Scénario fictif. L’extracteur lit un total différent de la somme des lignes. L’image est compressée et une remise apparaît dans une zone mal segmentée. La chaîne ne crée pas une alerte antifraude. Elle classe d’abord le document en qualité insuffisante, tente une lecture alternative, puis présente au gestionnaire le total, les lignes et la zone ambiguë. Si la remise explique l’écart, le dossier continue sans trace de suspicion.
Le test vérifie que l’incertitude OCR ne monte jamais directement dans la matrice d’escalade. Il vérifie aussi que la correction humaine enrichit la recette d’extraction, pas un profil antifraude.
Scénario 2 — La photo réutilisée
Scénario fictif. Un système de similarité retrouve une photo proche dans deux dossiers. L’interface affiche les deux images, les dates et la raison de la similarité. L’enquêteur constate qu’il s’agit d’un fichier transmis deux fois pour le même événement, dans deux étapes du parcours. Le signal est classé « doublon de flux » et non « tentative de fraude ».
Le test vérifie que la similarité ne suffit pas à établir l’identité des événements, que les dossiers ne sont rapprochés que selon une finalité et des accès autorisés, et que le classement sans suite corrige les indicateurs agrégés.
Scénario 3 — Les signaux convergents
Scénario fictif. Un document lisible présente un identifiant fournisseur incohérent avec une source indépendante, un total recalculé divergent et une métadonnée technique atypique. Les trois signaux proviennent de contrôles différents. Le dossier est priorisé pour une revue habilitée. L’IA ne propose pas une conclusion ; elle fournit les observations, les sources et les actions de vérification. La qualification éventuelle suit ensuite la procédure de l’organisme.
Le test vérifie la distinction entre convergence réelle et duplication d’une même erreur, la conservation des éléments, l’accès restreint et l’absence de conséquence automatique avant l’examen.
Préparer les tests avant la production
Le corpus doit contenir des documents ordinaires, des anomalies légitimes, des altérations simulées et des cas indéterminés. Il faut documenter l’origine, les droits d’utilisation, la représentativité et les limites. Les cas de test ne doivent pas devenir une collection de « fraudeurs » présumés sans vérité terrain fiable.
Pour les modèles multimodaux, l’évaluation doit séparer la lecture visuelle, l’extraction, le raisonnement et la justification. Une bonne réponse finale peut masquer une mauvaise localisation de preuve. L’article sur l’évaluation des modèles multimodaux en assurance propose précisément de ne pas mélanger ces niveaux.
Les tests adversariaux sont également importants : document volontairement bruité, champs recouverts, éléments injectés dans une image, fichier corrompu, ordre de pages modifié, information contradictoire entre texte et image. L’objectif n’est pas seulement de voir si le modèle « trouve la fraude », mais s’il conserve une conduite sûre lorsqu’il ne comprend plus l’entrée.
Surveillance, dérive et contestation
Les formats de pièces changent, les tactiques d’altération évoluent et le mix de dossiers se déplace. Il faut donc surveiller les entrées, les sorties et les décisions humaines. Une hausse d’alertes peut signifier une nouvelle menace, mais aussi un changement de modèle documentaire, une régression OCR ou un seuil mal calibré.
La surveillance doit permettre de relier un incident à la version du modèle, aux règles et aux données de référence. Elle doit aussi mesurer le délai avant correction. Lorsqu’une règle est invalidée, l’organisation doit pouvoir identifier les dossiers affectés et réexaminer ceux pour lesquels le signal a contribué à une conséquence.
La contestation n’est pas seulement un sujet juridique placé à la fin du parcours. C’est une source de qualité. Les explications apportées par les personnes et les renversements de décision révèlent les angles morts du système. Ils doivent alimenter une boucle d’amélioration contrôlée, sans être réutilisés automatiquement comme vérité d’entraînement.
Un plan de mise en œuvre en quatre lots
Lot 1 — Cartographier. Décrire la finalité, les documents, les données, les décisions aval, les personnes affectées et les équipes habilitées. Qualifier avec le DPO et les fonctions juridiques la base légale, l’information, les droits, les durées et l’éventuelle analyse d’impact.
Lot 2 — Séparer. Écrire les contrats d’entrée et de sortie de chaque étape. Interdire les libellés accusatoires dans les couches techniques. Prévoir l’abstention, la demande de pièce et le classement sans suite.
Lot 3 — Évaluer. Construire un corpus représentatif, tester les niveaux séparément, segmenter les erreurs, vérifier la calibration et faire relire les alertes en aveugle. Définir les seuils d’escalade avant de voir les résultats finaux.
Lot 4 — Déployer progressivement. Commencer sans conséquence automatique, limiter les flux, former les réviseurs, surveiller les files et auditer les renversements. N’augmenter l’exposition que lorsque la capacité de revue et la qualité des preuves sont établies.
La règle de conception
Le système doit aider à répondre à « que faut-il vérifier ? », jamais prétendre répondre seul à « qui a fraudé ? ». Cette règle simple transforme l’interface, les données, les métriques et les responsabilités. Elle réduit le risque de biais d’automatisation et améliore aussi l’efficacité : une observation précise et localisée est plus actionnable qu’un score général dont personne ne sait quoi faire.
L’article 22 du RGPD et les ressources de la CNIL imposent d’examiner sérieusement les décisions automatisées et leurs effets. L’EIOPA appelle à une gouvernance proportionnée fondée sur le risque dans l’assurance. Le règlement européen sur l’IA, lorsqu’une exigence s’applique au système considéré, renforce l’attention portée à la gestion des risques, aux données, aux journaux, au contrôle humain et à la robustesse. Aucun de ces textes ne transforme un score d’anomalie en preuve.
Questions fréquentes
Un score élevé autorise-t-il à bloquer automatiquement un dossier ?
Pas à lui seul. Le score doit être relié à des observations vérifiables, à une finalité et à une action proportionnée. Plus la conséquence est importante pour la personne, plus la preuve, la supervision et les voies de contestation doivent être solides. La qualification juridique du dispositif doit être menée sur son fonctionnement réel.
Faut-il montrer le score au gestionnaire ?
Pas nécessairement. Un nombre sans calibration ni explication peut créer un biais d’ancrage. L’interface gagne souvent à afficher d’abord les faits : zone, incohérence, règle, qualité de lecture et information manquante. Si un score est affiché, sa signification, ses limites et la conduite attendue doivent être compréhensibles.
Peut-on réentraîner automatiquement le modèle à partir des décisions humaines ?
Ce serait risqué. Les décisions humaines peuvent être erronées, influencées par l’interface ou refléter une procédure locale. Elles doivent être revues, documentées et qualifiées avant de devenir une vérité d’entraînement. Un classement sans suite n’établit pas toujours que le signal technique était faux ; il peut signifier que la preuve était insuffisante.
Sources et références
- Règlement (UE) 2016/679 — RGPD, EUR-Lex.
- Permettre le bon exercice de leurs droits par les personnes — CNIL.
- Droit des personnes et profilage : les spécificités du secteur de l’assurance — CNIL.
- Opinion on Artificial Intelligence governance and risk management — EIOPA, 6 août 2025.
- Développer la confiance dans l’IA par une approche par les risques cyber — ANSSI et partenaires.
Vous concevez un contrôle documentaire assisté par l’IA ? Commencez par nommer les signaux, les abstentions et les actions autorisées à chaque niveau. Cette grammaire protège les personnes et rend les enquêtes plus efficaces. Pour confronter votre chaîne actuelle à cette méthode, parlons de votre cas d’usage.