Ce qu’il faut retenir
- La dérive ne désigne pas un seul phénomène : données entrantes, relation entre données et résultat, modèle ou fournisseur, connaissances, usages, processus et impacts peuvent évoluer séparément.
- Un indicateur statistique sur les entrées ne suffit pas. Un système peut recevoir les mêmes dossiers et devenir moins utile après un changement de consigne, de barème, d’interface ou de comportement humain.
- Chaque alerte doit être reliée à une décision prévue : observer, limiter, faire revoir, revenir à une version, suspendre une action ou ouvrir un incident. Sans réponse, le tableau de bord devient décoratif.
- Les seuils sont propres au cas d’usage et au coût des erreurs. Ils sont établis sur une référence documentée, testés sur l’historique disponible et revus lorsque le contexte change.
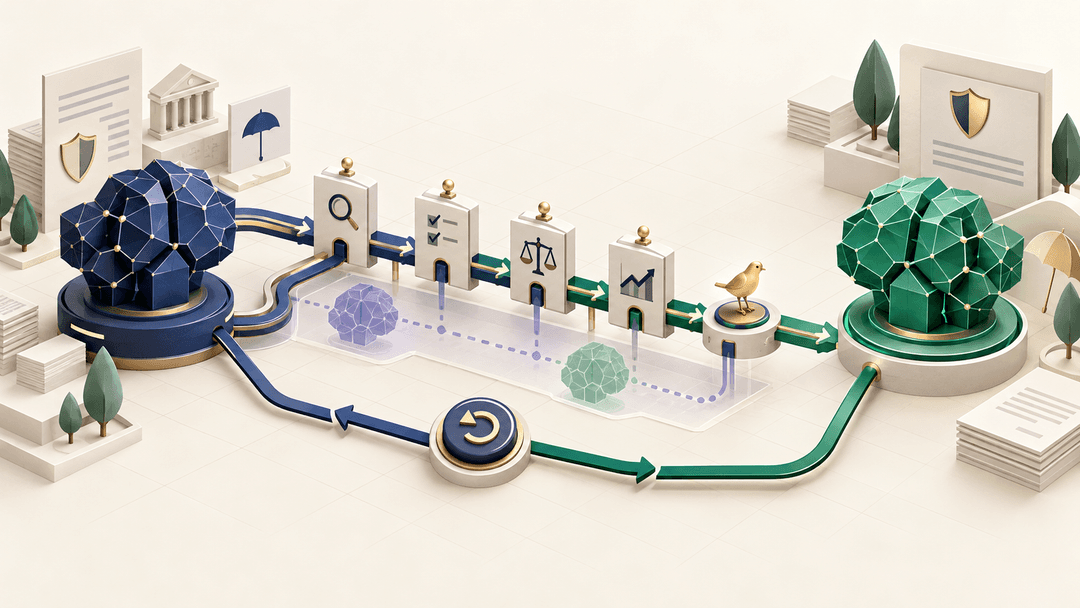
- Le triage distingue quatre temps : alerte, diagnostic, correction et vérification. Une corrélation temporelle n’établit pas la cause ; revenir en arrière sans comprendre peut masquer ou déplacer le défaut.
Un modèle peut conserver le même nom, répondre sans erreur technique et pourtant ne plus tenir sa promesse métier. Les dossiers reçus ont changé, les utilisateurs emploient l’outil autrement, une nouvelle procédure modifie la vérité attendue, le fournisseur met à jour une version ou les conséquences se concentrent sur un segment. Parler seulement de « data drift » réduit alors le problème à ce qui est le plus facile à tracer.
Dans l’assurance, la surveillance doit suivre la chaîne complète : dossier, connaissance, calcul, recommandation, intervention humaine, action et résultat. Elle doit aussi accepter que la vérité arrive tard. La qualité d’un tri peut être mesurée rapidement ; la pertinence d’une orientation peut n’être confirmée qu’après instruction, réclamation ou issue du dossier.
La question n’est donc pas « quel outil détecte la dérive ? », mais quel changement pourrait rendre ce système moins fiable, moins équitable, moins sûr ou moins utile, et quelle décision prendrons-nous lorsqu’il apparaît ?
La dérive est un écart à une promesse contextualisée
Une dérive existe par rapport à une référence et à un contrat de service. Pour un système qui extrait des informations de documents, la promesse peut porter sur la complétude de champs critiques, la provenance visuelle, l’abstention lorsque la pièce est illisible et le délai de traitement. Pour un copilote de souscription, elle peut porter sur la fidélité aux sources, la détection des manquants et l’absence d’action sans validation.
Cette définition oblige à distinguer trois situations :
- changement sans dégradation : les entrées évoluent, mais le service reste conforme ;
- dégradation sans changement d’entrée visible : une version, une consigne ou une dépendance altère le résultat ;
- amélioration moyenne avec dommage local : le résultat global progresse alors qu’un cas critique ou un segment se dégrade.
La moyenne ne tranche donc pas. La surveillance doit reprendre les dimensions qui ont justifié la mise en production. L’article sur les sept indicateurs d’un POC IA créateur de valeur pose cette discipline en amont ; le présent guide la prolonge dans le temps.
Sept familles de dérive en assurance
1. Dérive des données entrantes
La fréquence des types de pièces, leur format, leur langue, leur qualité, la distribution des produits ou la part de champs manquants évoluent. Un nouveau portail peut compresser les images ; une campagne peut attirer un autre profil de dossiers. Le système n’est pas forcément fautif, mais son domaine de validité doit être réévalué.
2. Dérive de la cible ou du concept
La relation entre l’entrée et le résultat attendu change. Une règle métier, une garantie, un barème, une nomenclature ou une politique d’orientation est modifiée. Le modèle peut reproduire fidèlement un monde qui n’existe plus. Dans ce cas, surveiller uniquement la forme des données ne détecte rien.
3. Dérive du modèle ou du fournisseur
Une version, un paramètre par défaut, un filtre, une politique de sécurité ou une infrastructure évolue. Le comportement peut changer même lorsque l’API et le nom commercial restent stables. Versionner les requêtes, paramètres et réponses de test devient indispensable. Le routeur de modèles doit lui aussi être surveillé : changer la répartition des appels peut modifier qualité, coût et exposition aux fournisseurs.
4. Dérive des connaissances et instructions
Le corpus documentaire vieillit, une source est retirée, les droits changent, une indexation échoue ou une instruction devient incohérente avec la procédure. Dans un système de génération augmentée par recherche, une réponse peut paraître correcte tout en citant la mauvaise version d’un contrat ou d’un guide.
5. Dérive des usages humains
Les utilisateurs contournent une étape, copient davantage de données, valident plus vite ou utilisent l’outil pour une finalité non prévue. Le système socio-technique a dérivé même si son modèle n’a pas changé. Les motifs de désaccord, le temps de revue, les demandes hors périmètre et les retours utilisateurs sont alors des indicateurs de premier rang.
6. Dérive du processus et des dépendances
Une API en aval modifie son schéma, une file se remplit, un contrôle déterministe est désactivé ou une équipe change d’habilitation. L’IA peut produire la bonne sortie, mais le système complet l’exécute mal. Les traces doivent couvrir les composants, pas seulement les jetons et la latence du modèle.
7. Dérive des résultats et impacts
Les reprises, réclamations, délais, coûts ou écarts entre segments évoluent. Ces signaux tardifs sont essentiels : ils révèlent les conséquences que les métriques techniques n’avaient pas anticipées. Ils doivent être rapprochés avec prudence. Une hausse des réclamations concomitante à une mise à jour justifie une enquête ; elle ne prouve pas que la mise à jour en est la cause.
Construire un tableau d’indicateurs relié au risque
Tableau — Indicateurs et réponses possibles pour six familles de dérive
| Famille | Indicateurs possibles | Ventilation utile | Réponse préparée |
|---|---|---|---|
| Entrées | Formats, langues, champs manquants, qualité d’image, valeurs hors domaine | Produit, canal, partenaire, période | Limiter, réorienter ou constituer un nouvel échantillon |
| Performance | Erreurs sur champs critiques, fidélité aux sources, abstention, rappel sur cas prioritaires | Type de cas, gravité, segment licite | Revue humaine renforcée ou retour à une version connue |
| Connaissance | Âge des sources, échecs d’indexation, citations introuvables, version inadéquate | Corpus, produit, juridiction | Geler le corpus, réindexer, retirer la source |
| Usage | Demandes hors périmètre, contournements, temps de revue, désaccords, escalades | Rôle, équipe, charge, ancienneté | Former, corriger l’interface ou réduire l’autonomie |
| Technique | Version, erreurs d’outil, latence, files, répétitions, coût par dossier terminé | Composant, fournisseur, région | Isoler une dépendance ou activer le mode dégradé |
| Impact | Reprises, réclamations, délais, rectifications, résultats par segment | Décision, produit, population pertinente | Enquête, suspension ciblée et analyse des dossiers affectés |
Chaque indicateur possède une fiche : définition, source, propriétaire, fréquence, fraîcheur, qualité, niveau de confidentialité, référence, règle d’alerte et décision associée. Sans cette fiche, deux équipes peuvent compter différemment le même « taux d’erreur » ou comparer des périodes non homogènes.
Les métriques techniques sont rapprochées d’un résultat métier. Une baisse de latence n’a de valeur que si elle réduit un délai utile sans augmenter les reprises. Une hausse de l’abstention peut protéger les dossiers difficiles ou transférer une charge excessive aux équipes. L’objectif n’est pas de maximiser un score, mais de maintenir un service dans sa tolérance de risque.
Mesurer quand la vérité arrive tard
Le tableau de bord distingue les signaux immédiats et les résultats confirmés. Pour un extracteur, une revue d’échantillon fournit rapidement une mesure. Pour une recommandation de traitement, la vérité peut arriver après une seconde expertise ou une décision finale. L’équipe conserve alors des cohortes par version et date, puis met à jour la mesure lorsque le résultat devient disponible.
Les corrections humaines peuvent servir de signal, mais pas automatiquement de vérité. Elles doivent être confirmées selon le risque. Une hausse des corrections peut indiquer une dérive, une formation plus exigeante ou un nouveau profil de dossier.
Choisir la référence et les fenêtres de comparaison
Une référence utile n’est pas nécessairement toute l’histoire. Elle correspond à une période ou un jeu de données où le service a été évalué dans des conditions connues. Elle décrit les volumes, segments, versions, politiques et limites. Lorsque le métier est saisonnier, comparer septembre à août peut déclencher une alerte attendue ; une référence saisonnière ou une comparaison à plusieurs niveaux est préférable.
Trois fenêtres se complètent :
- courte : détecter une rupture brutale, une panne ou une mise à jour fautive ;
- intermédiaire : distinguer un incident d’une tendance durable ;
- longue : observer saisonnalité, changement de portefeuille et impacts retardés.
Les durées et seuils dépendent du volume et du dommage possible. Un flux peu fréquent peut nécessiter une analyse par événement plutôt qu’un seuil statistique. Un grand volume permet des alertes plus rapides, mais rend aussi de petits écarts statistiquement visibles sans importance métier. L’équipe documente donc une importance pratique : quels dossiers ou effets justifient une action.
Évitez de multiplier les tests sans gouvernance. Plus le tableau de bord contient d’indicateurs, plus les alertes fortuites augmentent et plus l’attention se disperse. Hiérarchisez : quelques bloqueurs de sécurité et d’intégrité, des indicateurs de performance par risque, puis des signaux exploratoires destinés au diagnostic.
De l’alerte au diagnostic
1. Qualifier l’alerte
Vérifiez d’abord la donnée de surveillance elle-même : rupture de collecte, changement de définition, retard de vérité ou échantillon trop petit. Puis décrivez le signal sans conclure à la cause : « la part de pièces orientées en revue a augmenté sur le canal X depuis telle version » est préférable à « le modèle a dérivé ».
2. Estimer l’impact et la propagation
Quels dossiers, produits, périodes et actions sont concernés ? L’effet est-il déjà communiqué au client, réversible ou encore interne ? Le système doit-il être limité immédiatement ? Le guide des traces nécessaires pour expliquer un incident aide à relier version, entrée, sortie, outil et effet sans reconstruire l’histoire à la main.
3. Formuler plusieurs hypothèses
- les entrées ont changé ;
- la cible métier ou les annotations ont changé ;
- un modèle, un prompt ou un paramètre a évolué ;
- le corpus ou les droits de recherche se sont dégradés ;
- un composant aval transforme mal une sortie correcte ;
- les utilisateurs se comportent autrement ;
- un facteur extérieur explique simultanément le signal et le résultat.
4. Chercher des observations discriminantes
Rejouez un échantillon figé sur les versions ancienne et nouvelle ; comparez des entrées proches avant et après la rupture ; inspectez les sources retrouvées ; vérifiez le schéma de l’outil ; interrogez les opérateurs ; rapprochez les changements de configuration. Un seul test ne prouve pas toujours la cause. L’objectif est d’éliminer les hypothèses, pas de confirmer la première intuition.
Le Playbook du NIST AI RMF, fonction Measure, recommande de réévaluer régulièrement la pertinence des métriques, de suivre les entrées externes, de tester sous stress et de surveiller le comportement en production. Le cadre est volontaire et transversal ; il doit être adapté au contexte assurance et à la tolérance de risque.
Corriger, limiter ou revenir en arrière
Tableau — Réponses graduées à une dérive et conditions de retour au nominal
| Réponse | Quand l’envisager | Condition de sortie |
|---|---|---|
| Observer renforcé | Signal faible, impact limité, données encore insuffisantes | Échantillon ou délai défini, propriétaire nommé |
| Revue humaine accrue | Performance incertaine mais service utile et dossiers vérifiables | Capacité humaine réelle et critères d’escalade |
| Limiter le périmètre | Dérive concentrée sur un canal, produit, format ou action | Routage fiable et absence de contournement |
| Retour arrière | Régression liée à une version identifiée | Version antérieure disponible, compatible et encore sûre |
| Corriger puis tester | Cause comprise dans données, règles, prompt, modèle ou intégration | Non-régression sur cas affectés et cas voisins |
| Suspendre | Intégrité, confidentialité, impact ou propagation non maîtrisés | Mode dégradé et gouvernance de reprise activés |
Le retour arrière n’est sûr que si la version précédente est entière : modèle, instructions, corpus, schémas, règles et dépendances. Revenir au modèle sans revenir au format d’outil peut créer un nouveau défaut. Conservez des manifestes de version et exercez le mécanisme de reprise.
Après correction, rejouez d’abord les cas affectés, puis des cas voisins et le jeu de non-régression général. Vérifiez les effets collatéraux : réduire les faux positifs peut augmenter les faux négatifs ; rendre l’agent plus prudent peut saturer la file humaine. La remise en production est progressive et observable.
Scénario hypothétique : extraction de pièces de souscription
Imaginons un système qui extrait l’activité, le chiffre d’affaires déclaré et certaines dates à partir de documents professionnels. Il joint une provenance à chaque champ et abstient lorsque la lecture est insuffisante. Ce scénario est fictif ; aucune performance ni aucun incident réel n’est avancé.
Le tableau de bord signale une hausse des abstentions sur un canal. Les erreurs confirmées n’ont pas encore augmenté. L’équipe ne conclut pas immédiatement à une dérive du modèle. Elle vérifie la collecte et observe qu’une nouvelle méthode de numérisation produit des images plus compressées. En parallèle, un nouveau type de justificatif est apparu.
Deux causes différentes demandent deux réponses. Le canal peut transmettre une version de meilleure qualité ou orienter les documents illisibles vers une reprise. Le nouveau justificatif doit être qualifié, annoté et ajouté aux cas de test avant toute extension. Réentraîner globalement le système sur le mélange des dossiers aurait masqué la distinction et rendu la recette moins interprétable.
Supposons ensuite que les champs critiques restent correctement extraits, mais que le temps de traitement humain augmente. L’entretien révèle que l’interface affiche moins clairement la provenance après une mise à jour. La dérive est alors dans la configuration socio-technique, pas dans la prédiction. Le bon correctif porte sur l’interface et la recette d’usage.
Gouvernance et cadre applicable
Le propriétaire du système organise la surveillance, mais ne doit pas en être l’unique lecteur. Métier, data, produit, risque, conformité, sécurité et opérations interprètent des signaux différents. Une seconde ligne peut challenger les seuils, les segments, les causes et la décision de reprise. Les responsabilités et droits d’arrêt sont inscrits dans le registre du système.
L’avis de l’EIOPA du 6 août 2025 sur la gouvernance et la gestion des risques IA adopte une approche proportionnée et fondée sur les risques, avec des attentes relatives notamment aux responsabilités, à l’équité, à l’explicabilité, aux données et à la documentation. Son champ annoncé exclut les pratiques interdites et systèmes à haut risque du règlement IA ; il éclaire la gouvernance sectorielle sans remplacer l’analyse des autres textes.
L’article 72 du règlement européen sur l’intelligence artificielle, dans sa version consolidée au 27 juillet 2026, prévoit, pour les fournisseurs de systèmes d’IA à haut risque concernés, un système documenté de surveillance après commercialisation, proportionné à la nature des technologies et aux risques du système. Cette obligation a un titulaire, un champ et un calendrier d’application à qualifier selon le système ; elle ne doit pas être attribuée indistinctement à tout utilisateur d’IA. Un déployeur doit néanmoins organiser sa propre maîtrise du service selon ses rôles et obligations applicables.
Le NIST AI Risk Management Framework structure volontairement la gestion autour de Govern, Map, Measure et Manage. Sa fonction Measure demande notamment que le comportement et les composants soient suivis en production ; le site du NIST indique également que la version 1.0 est en révision. Au 7 septembre 2026, il faut donc dater la référence et ne pas présenter le cadre comme une norme figée ou obligatoire en Europe.
Plan de surveillance opérationnel
- Inventorier la promesse : décisions, sorties, actions, populations, dommages et limites acceptées.
- Cartographier les dérives : une hypothèse concrète dans chacune des sept familles, avec son signal possible.
- Choisir les indicateurs : privilégier ceux qui changent une décision ; documenter les angles morts.
- Fixer les références : version, période, saisonnalité, segments, qualité des données et incertitude.
- Préparer les réponses : propriétaire, délai interne, contrôle humain, limitation, retour arrière et arrêt.
- Instrumenter les versions : modèle, prompts, corpus, règles, outils, interface et politiques.
- Tester les alertes : injecter une rupture sûre, vérifier le signal, l’escalade et la réponse.
- Relier les résultats tardifs : reprises, réclamations et décisions confirmées à la version qui les a produits.
- Revoir périodiquement : supprimer les indicateurs inutiles, ajuster les seuils et couvrir les nouveaux usages.
Le livrable final n’est pas un tableau de bord. C’est un contrat de surveillance : « si ce signal apparaît dans ce périmètre, cette personne examine ces preuves et peut prendre cette action ». Il doit rester compréhensible par le métier et testable par les équipes techniques.
Questions fréquentes
Une variation des données signifie-t-elle qu’il faut réentraîner ?
Non. Vérifiez d’abord si la performance et l’impact se dégradent, si le changement est légitime et si le modèle doit couvrir ce nouveau domaine. La bonne réponse peut être un nouveau routage, une règle, une collecte corrigée ou une abstention.
Existe-t-il un seuil universel de dérive ?
Non. Le seuil dépend de la métrique, du volume, de la saisonnalité, du coût d’erreur et de la réponse disponible. Il doit être calibré et documenté sur le cas d’usage.
Comment surveiller un modèle fourni par API ?
Conservez la version annoncée lorsqu’elle existe, les paramètres, un jeu de sondes stable et les résultats de production pertinents. Surveillez aussi les erreurs, politiques, latences et changements documentés du fournisseur. Votre contrat métier reste la référence.
La dérive concerne-t-elle aussi un système génératif ?
Oui. Les métriques changent : fidélité aux sources, citations, abstention, respect du format, sécurité des outils, qualité par scénario et revue humaine. Une note moyenne de similarité ne couvre pas ces risques.
Sources et références
- NIST, Artificial Intelligence Risk Management Framework, page officielle indiquant l’état du cadre et ses ressources ; consultée le 7 septembre 2026.
- NIST AI RMF Core — fonction Measure, dont la surveillance en production et l’évaluation dans le contexte de déploiement.
- NIST AI RMF Playbook — Measure, suggestions volontaires sur les métriques, le stress et le suivi des changements.
- NIST AI 600-1, Generative Artificial Intelligence Profile, publié en juillet 2024 et mis à jour sur la page officielle en avril 2026.
- EIOPA, Opinion on Artificial Intelligence governance and risk management, 6 août 2025.
- Règlement (UE) 2024/1689 sur l’intelligence artificielle, notamment article 72 sur la surveillance après commercialisation ; texte officiel consulté le 7 septembre 2026.
- Règlement (UE) 2026/1744 modifiant notamment l’article 72, entré en vigueur le 27 juillet 2026.
Passer du tableau de bord au dispositif de décision
Un atelier de surveillance peut relier vos risques, vos données disponibles, vos seuils et vos réponses avant la production ou une extension de périmètre. Échangeons sur le plan de dérive de votre système IA d’assurance.